¿Te has dado cuenta de lo rápido que crecen nuestros conjuntos de datos? Parece que cada vez hay más y más información para procesar. ¡Es casi como si estuviéramos tratando de beber de una manguera! Pero no te preocupes, para eso existe el algoritmo k-means. Uno de los métodos más utilizados en el campo de la minería de datos y el machine learning para el agrupamiento de información. Si quieres saber de qué trata, sigue leyendo.
Te puede interesar: Máster en Data Science
¿Qué es K- means clustering?
El algoritmo k-means es un método de agrupamiento que divide un conjunto de datos en k grupos o clusters. Los datos se agrupan de tal manera que los puntos en el mismo clúster sean más similares entre sí que los puntos en otros clusters.
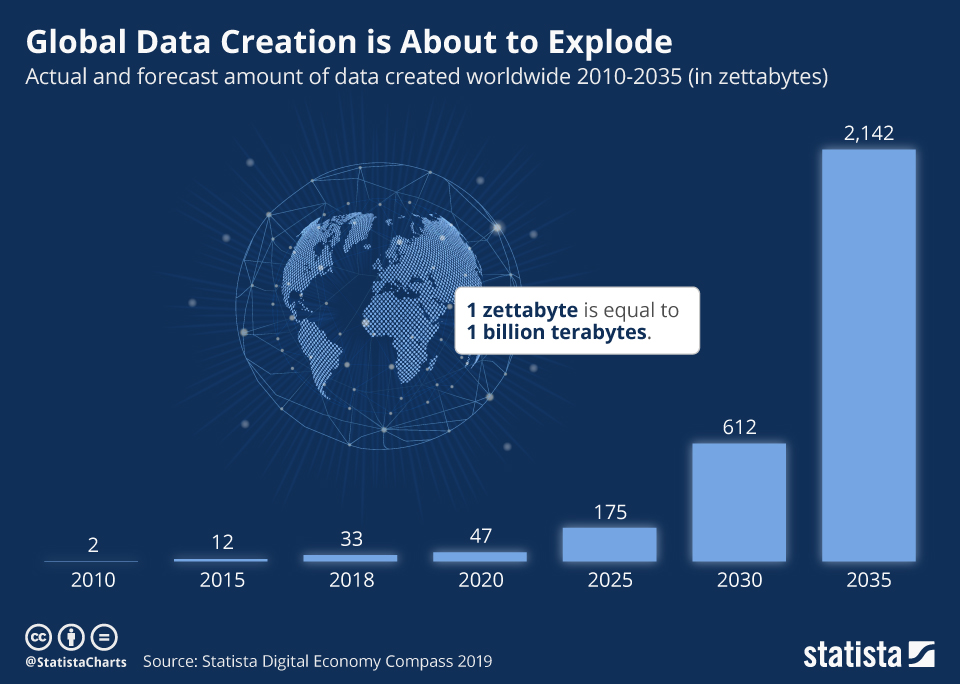
Del universo de algoritmos de aprendizaje no supervisado, K-means sigue siendo uno de los algoritmos más conocidos para el aprendizaje no supervisado, aunque alternativas más avanzadas como DBSCAN o algoritmos basados en clustering espectral han ganado popularidad en ciertos escenarios debido a su capacidad para manejar conjuntos de datos más complejos y de mayor dimensión. La razón por la que existe este método es porque en 2024, la cantidad total de datos creados, capturados, copiados y consumidos globalmente ha superado los 200 Zettabytes, impulsada principalmente por el crecimiento de dispositivos IoT, la inteligencia artificial generativa y las redes 5G. Con el algoritmo k- means es posible recopilar grandes cantidades de información similar en un mismo lugar, hecho que ayuda a encontrar patrones y hacer predicciones en grandes conjuntos de datos.
¿Cómo funciona el algoritmo K- means?
Para utilizar el algoritmo K-means, primero se especifica el número de clusters deseados (k). Por ejemplo, al establecer «k» igual a 2, su conjunto de datos se agrupará en 2 grupos, mientras que si establece «k» igual a 4, agrupará los datos en 4 grupos.
Cada grupo está representado por su centro o centroide, que corresponde a la media aritmética de los puntos de datos asignados al grupo. De esta manera, el algoritmo funciona a través de un proceso iterativo hasta que cada punto de datos está más cerca del centroide de su propio grupo que de los centroides de otros grupos, minimizando la distancia dentro del grupo en cada paso.
A continuación detallamos cómo funciona paso a paso el algoritmo K- means:
- Especificar el número de clústers deseados (k): El primer paso es especificar cuántos clúster queremos dividir el conjunto de datos. Este número se denomina k.
- Seleccionar k puntos al azar del conjunto de datos como los centroides iniciales de cada clúster: Luego, se eligen k puntos al azar del conjunto de datos para servir como los centroides iniciales de cada clúster. Estos centroides son el punto central o el promedio de cada clúster.
- Asignar cada punto del conjunto de datos al cluster cuyo centroide esté más cerca: A continuación, el algoritmo asigna cada punto del conjunto de datos al cluster cuyo centroide esté más cerca. Para hacer esto, se calcula la distancia entre cada punto y cada centroide y se asigna el punto al cluster cuyo centroide tenga la menor distancia.
- Recalcular los centroides de cada cluster como la media de todos los puntos del cluster: Una vez que todos los puntos han sido asignados a un cluster, se recalculan los centroides de cada cluster como la media de todos los puntos del cluster. Esto significa que se actualiza la posición del centroide para reflejar la nueva agrupación.
- Repetir los pasos 3 y 4 hasta que los centroides de los clusters ya no cambien o hasta que se alcance el número máximo de iteraciones.
¿Cómo saber qué valor asignar a k?
Cuando defines «k», le estás diciendo al algoritmo cuántos centroides desea, pero ¿cómo sabe cuántos grupos producir?
Hay varias formas de encontrar el valor óptimo de k en el algoritmo k-means:
- Usar el método del codo: El método del codo sigue siendo una técnica popular para encontrar el valor óptimo de k, aunque en 2024 se han introducido herramientas más avanzadas, como el uso de inteligencia artificial para estimar automáticamente el número óptimo de clusters basándose en análisis más complejos de los datos. Para hacerlo, se grafican los valores de k junto con la suma de los errores cuadrados (SSE) para cada valor de k. El SSE es la suma de la distancia de cada punto al centroide de su cluster. A medida que aumenta k, el SSE disminuye, pero a un ritmo cada vez menor. El punto en el que el SSE disminuye más lentamente se conoce como el codo y es el punto óptimo para elegir k.
- Utilizar técnicas de validación cruzada: Otra forma de encontrar el valor óptimo de k es utilizar técnicas de validación cruzada, como la validación cruzada de k-fold. Esto implica dividir el conjunto de datos en k subconjuntos y entrenar el algoritmo k-means k veces, cada vez utilizando un subconjunto diferente.
Pasos para llevar a cabo un minado de datos
Cuándo usar la agrupación en clusters K-means
El algoritmo k-means es rápido y fácil de implementar, lo que lo convierte en una opción popular para la agrupación de datos. A pesar de ser útil, el algoritmo k-means enfrenta limitaciones en 2024, especialmente en conjuntos de datos grandes y complejos donde no solo es sensible a los valores iniciales, sino que también muestra dificultades en la detección de clusters no esféricos. Algoritmos más avanzados y modelos basados en aprendizaje profundo pueden manejar mejor estas situaciones.
Las aplicaciones del algoritmo k-means siguen siendo relevantes en 2024, pero con la expansión de nuevas tecnologías, ahora también se utiliza en áreas como la segmentación en metaversos, el análisis de datos generados por IA generativa, y la optimización de flujos de trabajo en procesos industriales mediante IoT.
- Segmentación de clientes: Puede utilizarse para dividir a los clientes en diferentes grupos en función de sus características o comportamientos. Esto puede ser útil para enviar campañas de marketing más personalizadas o para tomar decisiones de negocio.
- Clasificación de texto: Puede utilizarse para clasificar documentos o artículos en diferentes categorías en función de su contenido.
- Detección de anomalías: Puede utilizarse para detectar patrones anormales en un conjunto de datos y señalar posibles problemas o errores.
En resumen, el algoritmo k-means es una herramienta útil para la agrupación de datos y el aprendizaje automático. Tiene grandes ventajas y sigue siendo una opción popular para muchos problemas de clasificación.
¿Qué te ha parecido este artículo sobre el algoritmo K-means? ¡Déjanos tu opinión en los comentarios! Si quieres convertirte en un experto en el análisis y la minería de datos, te invitamos a formarte en nuestro Máster en Análisis de Datos. Un programa en el que aprenderás a utilizar las técnicas y herramientas más importantes para manejar grandes volúmenes de datos y aplicar todos los algoritmos de Machine Learning.