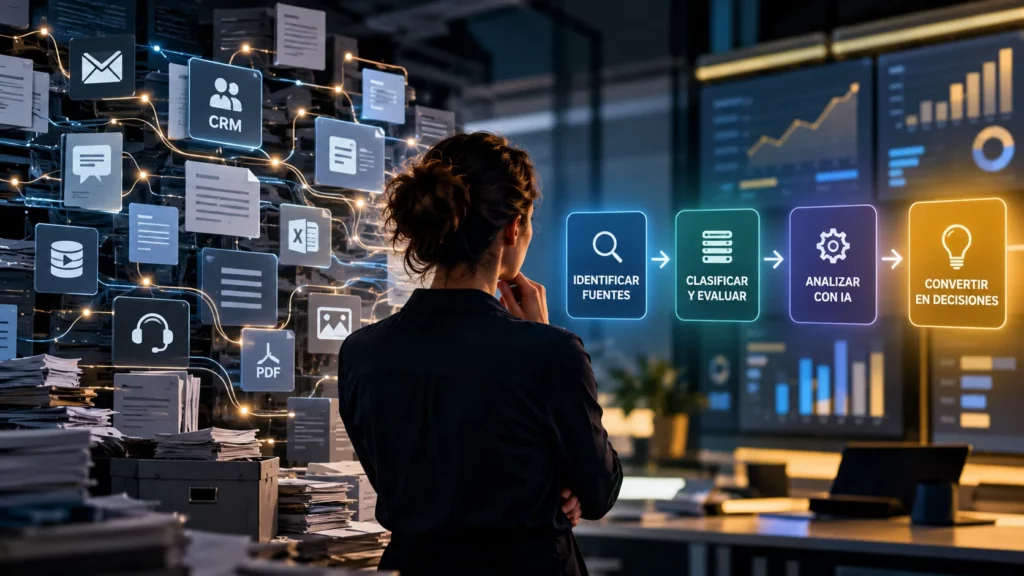
Los Dark Data, o datos oscuros, son la información que una empresa recopila y almacena, pero que no utiliza para analizar su actividad ni tomar decisiones. Pueden ser conversaciones con clientes, informes olvidados, registros de aplicaciones, correos electrónicos o documentos acumulados durante años. Algunos contienen conocimiento valioso; otros son duplicados, están desactualizados o no deberían seguir conservándose.
Imagina que tu empresa lleva cinco años registrando miles de conversaciones comerciales. Sabes cuántas ventas has conseguido, pero nunca has analizado qué objeciones se repiten entre los clientes que no compran. Quizá el precio no sea el verdadero problema. Quizá muchos abandonan porque no entienden cómo se implanta tu producto. La respuesta podría estar en tu propio CRM, esperando a que alguien formule la pregunta adecuada.
Ahí reside el interés de los Dark Data: pueden contener respuestas a problemas que la empresa todavía no ha sabido investigar. Y la inteligencia artificial ha ampliado las posibilidades de encontrar patrones en grandes volúmenes de documentos, conversaciones y registros.vPero hay una diferencia enorme entre disponer de información y poder confiar en ella.
En esta guía aprenderás a reconocer los Dark Data, descubrir dónde se esconden, evaluar su utilidad y aplicar un método para convertirlos en conocimiento aprovechable. Seguiremos el caso de una empresa que intenta comprender por qué pierde clientes y veremos qué puede resolver con sus propios datos, con y sin inteligencia artificial.
Qué son los Dark Data y por qué las empresas acumulan tantos
El término Dark Data describe información almacenada que no se utiliza de forma efectiva. IBM lo emplea para referirse a los datos que las organizaciones acumulan sin incorporarlos habitualmente al análisis o a la toma de decisiones.
No es una categoría tecnológica como Big Data, ni un formato como JSON, CSV o PDF. Un dato puede estar perfectamente organizado en una base de datos y seguir siendo invisible para quienes podrían aprovecharlo.
Pensemos en tres situaciones:
- Una empresa guarda los motivos por los que pierde oportunidades comerciales, pero nunca los analiza conjuntamente.
- Una fábrica conserva registros de incidencias de sus máquinas, aunque mantenimiento sólo consulta las averías más recientes.
- Un departamento de recursos humanos acumula evaluaciones y proyectos realizados por sus empleados, pero no utiliza esa información para detectar capacidades internas.
En los tres casos existe información que podría aportar conocimiento. Lo que falta es conectarla con una decisión.
¿Cuántos datos permanecen sin utilizar?
Una investigación de Splunk citada por IBM, realizada entre más de 1.300 responsables empresariales y tecnológicos, encontró que el 60 % de los encuestados consideraba que al menos la mitad de los datos de su organización eran oscuros.
Es un dato histórico basado en percepciones de los participantes, no una medición universal del porcentaje de información desaprovechada en todas las empresas.
Lo interesante es el problema que refleja: durante años hemos mejorado nuestra capacidad de capturar y almacenar información mucho más deprisa que nuestra capacidad de comprenderla.
Guardar se ha vuelto relativamente sencillo. Saber qué merece la pena conservar, relacionar y analizar sigue exigiendo criterio.
Dónde se esconden los datos oscuros: seis ejemplos que reconocerás
Los Dark Data no suelen encontrarse en una carpeta llamada «datos ocultos». Están repartidos por las herramientas que utiliza una empresa cada día.
| Dónde están | Qué información contienen | Qué podríamos descubrir |
|---|---|---|
| CRM y ventas | Notas comerciales, objeciones, oportunidades perdidas | Por qué algunos clientes no compran |
| Atención al cliente | Tickets, chats, reclamaciones | Problemas recurrentes del producto |
| Marketing | Campañas antiguas, respuestas, formularios | Preguntas y necesidades desatendidas |
| Recursos humanos | Proyectos, evaluaciones, experiencias | Competencias que ya existen en el equipo |
| Operaciones | Logs, sensores, incidencias | Patrones asociados a fallos |
| Documentación interna | Manuales, procedimientos, informes | Conocimiento que cuesta localizar |
Hay un matiz importante: datos oscuros y datos no estructurados no son sinónimos. Un correo electrónico suele contener información no estructurada. Un campo del CRM pertenece a una estructura definida. Ambos pueden convertirse en Dark Data si la organización los conserva sin aprovecharlos.
Tampoco todos merecen recuperarse. Algunos son irrelevantes, otros han perdido vigencia y otros contienen información personal o confidencial que requiere controles específicos.
Para entender cómo se distingue una oportunidad real de un simple montón de archivos, vamos a seguir un caso.
El caso de Nébula: una empresa que pierde clientes sin saber por qué
Nébula es una empresa ficticia que comercializa software de gestión para pequeñas empresas. Tiene 2.000 clientes, un equipo comercial de ocho personas y un departamento de soporte que atiende cientos de consultas cada mes.
La dirección detecta que una parte de los clientes cancela su suscripción durante los primeros meses. El cuadro de mando muestra cuántos abandonan y cuánto ingreso se pierde. Pero no explica por qué.
Ventas cree que el precio es demasiado alto. Producto sospecha que faltan funcionalidades. Soporte piensa que los clientes tienen dificultades para configurar el sistema. Cada departamento tiene una explicación diferente. Y todos poseen una parte de la información.
Primer descubrimiento: los datos ya existen
Nébula decide investigar las cancelaciones de los últimos seis meses. Encuentra cuatro fuentes:
- El CRM conserva los motivos de pérdida registrados por los comerciales.
- Soporte almacena los tickets de cada cliente.
- Producto dispone de registros de uso de determinadas funcionalidades.
- El equipo de atención conserva las respuestas a las encuestas de cancelación.
Ninguna fuente ofrece una explicación completa. El valor potencial aparece cuando pueden compararse, siempre que exista una finalidad legítima y un tratamiento adecuado de los datos.
Aquí surge el primer aprendizaje: recuperar Dark Data no consiste necesariamente en generar información nueva, sino en descubrir qué preguntas podemos responder con la que ya tenemos.
Segundo descubrimiento: los datos cuentan historias contradictorias
Supongamos que Nébula analiza una muestra autorizada de 200 cancelaciones. Los resultados de este ejemplo son ficticios.
EJEMPLO HIPOTÉTICO · 200 CANCELACIONES
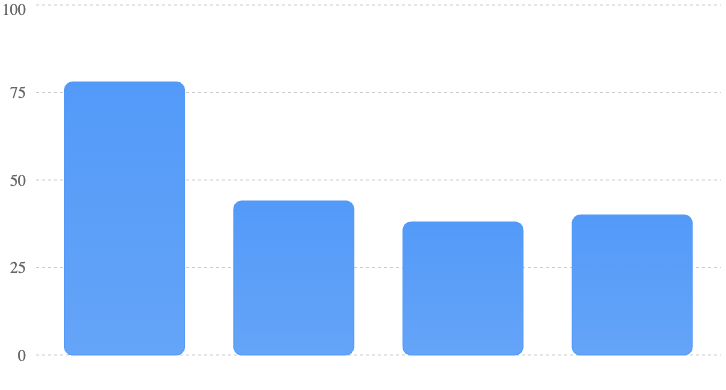
Categorías ilustrativas, mutuamente excluyentes, asignadas a un motivo principal por cancelación. No representan resultados reales de IEBS ni de empresas investigadas.
En este escenario, las dificultades de implantación aparecen como motivo principal más frecuente. El equipo podría haber estado dedicando sus esfuerzos a reducir precios cuando una parte importante del problema se encontraba en la incorporación de nuevos clientes.
Pero todavía no podemos afirmar que mejorar la implantación reducirá las cancelaciones. Para eso necesitamos comprobar la clasificación, estudiar posibles factores concurrentes y probar una intervención. Los datos nos han permitido formular una hipótesis mejor. Ahora toca ponerla a prueba.
Cómo convertir Dark Data en conocimiento útil: seis pasos
El proceso comienza antes de elegir una herramienta de inteligencia artificial.
1. Empieza por una decisión que quieras mejorar
«Queremos aprovechar nuestros datos» es una intención demasiado amplia.
En cambio, «queremos identificar los problemas que aparecen antes de que un cliente cancele» permite concretar qué información necesitamos.
Nébula define su pregunta: ¿qué incidencias se repiten entre los clientes que abandonan durante los primeros tres meses?
Esta decisión delimita las fuentes, el periodo y las personas responsables. También permite descartar información que no hace falta recopilar.
2. Haz un inventario de los datos disponibles
Antes de copiar miles de archivos a un nuevo repositorio, identifica qué sistemas contienen información relacionada con el problema.
Para cada fuente, registra su propietario, el tipo de datos, su fecha, los permisos y las limitaciones conocidas.
Ejemplo de inventario inicial de Nébula
| Fuente | Responsable | Estado |
|---|---|---|
| CRM | Dirección comercial | Utilizable tras revisar campos |
| Tickets | Responsable de soporte | Requiere limpieza |
| Registros de uso | Equipo de producto | Necesita comprobar integridad |
| Encuestas | Atención al cliente | Muestra limitada |
El inventario ya tiene valor por sí mismo. Permite saber qué información existe y evita que cada departamento vuelva a recopilarla por separado.
3. Comprueba si los datos pueden utilizarse
Que una empresa tenga acceso técnico a un archivo no significa que pueda utilizarlo para cualquier finalidad.
Cuando existen datos personales, el RGPD exige respetar principios como la licitud, la limitación de la finalidad, la minimización, la exactitud, la conservación limitada y la seguridad.
En Nébula, el análisis podría realizarse inicialmente con categorías agregadas y los datos mínimos necesarios, sin entregar conversaciones completas a una herramienta externa.
Si un registro contiene información especialmente sensible o su reutilización carece de base adecuada, debe excluirse hasta resolver esa cuestión.
La privacidad forma parte del diseño del análisis, no es una comprobación que se añade cuando todo está terminado.
4. Limpia y contextualiza la información
Ahora aparece uno de los problemas más habituales.
Dos departamentos pueden utilizar la palabra «incidencia» para referirse a cosas distintas. Un cliente puede haber abierto cinco tickets sobre el mismo problema. Una nota comercial puede describir una dificultad que ya se resolvió.
Antes de buscar patrones, Nébula necesita normalizar categorías, identificar duplicados y conservar la fecha de los registros.
También debe comprobar qué información falta.Si únicamente analiza a quienes contactaron con soporte, podría estar ignorando a los clientes que abandonaron sin pedir ayuda. La calidad de la conclusión depende de la calidad y representatividad de los datos disponibles.
5. Utiliza la IA cuando aporte una ventaja concreta
Aquí es donde la inteligencia artificial puede cambiar el trabajo. Un equipo humano podría revisar manualmente una muestra de tickets y clasificar los problemas. Si existen miles de documentos, un modelo de lenguaje puede ayudar a proponer etiquetas, resumir incidencias o localizar patrones.
Pero hay que comprobar su desempeño. Nébula podría seleccionar una muestra representativa, hacer que especialistas clasifiquen las incidencias y comparar después esas etiquetas con las generadas por IA.
Si el modelo confunde errores de configuración con fallos del producto, la clasificación necesita ajustes. El AI Risk Management Framework de NIST ofrece un marco voluntario para gobernar, identificar, medir y gestionar riesgos asociados a sistemas de IA.
La IA acelera determinadas tareas de análisis. La responsabilidad de decidir qué conclusiones son válidas permanece en la organización.
6. Convierte el descubrimiento en una prueba de negocio
Volvamos a Nébula. Tras revisar la información, el equipo sospecha que muchos clientes tienen dificultades durante la implantación.
En lugar de rediseñar todo el producto, decide probar un acompañamiento inicial más estructurado con un grupo de clientes. Mide cuántos completan la configuración, qué incidencias aparecen y cuántos continúan utilizando el servicio después de un periodo definido.
La comparación deberá considerar diferencias entre grupos y otros factores que puedan afectar a la retención. El proyecto de Dark Data empieza a generar valor cuando conduce a una decisión comprobable.
Y aquí aparece otra conclusión: no todos los datos recuperados necesitan convertirse en un dashboard, ni todas las decisiones necesitan inteligencia artificial.
Dark Data, Big Data y RAG: qué relación tienen
Estos conceptos suelen aparecer juntos, pero resuelven problemas diferentes.
| Concepto | Qué significa | Para qué sirve |
|---|---|---|
| Dark Data | Información almacenada y no aprovechada | Identificar patrimonio informativo infrautilizado |
| Big Data | Tratamiento de datos de gran volumen, variedad o velocidad | Procesar y analizar conjuntos complejos |
| Data Governance | Reglas, responsabilidades y controles sobre los datos | Mejorar calidad, acceso y trazabilidad |
| RAG | Recuperación de información para aportar contexto a un modelo generativo | Responder utilizando documentos o fuentes seleccionadas |
Una empresa puede tener Dark Data sin necesitar Big Data. También puede disponer de una infraestructura avanzada y continuar acumulando información inútil.
¿Puede un sistema RAG recuperar el conocimiento oculto?
Sí, en determinados casos. Imagina una organización con miles de manuales, procedimientos y documentos técnicos. Los empleados pierden tiempo buscando respuestas porque la información está dispersa.
Un sistema RAG puede recuperar fragmentos relevantes de documentos autorizados y utilizarlos como contexto para generar respuestas. Eso puede facilitar el acceso al conocimiento.
Sin embargo, RAG no garantiza que un documento sea correcto, esté actualizado o deba mostrarse a cualquier empleado.
Si la documentación contiene procedimientos antiguos, el asistente puede recuperar instrucciones que ya no deberían aplicarse.
Por eso es importante mantener versiones, responsables, controles de acceso y evaluaciones de calidad. Para profundizar en la evolución de estos sistemas, conviene distinguir la recuperación de información de la automatización completa de procesos mediante agentes.
Cuándo merece la pena recuperar datos y cuándo es mejor eliminarlos
Hasta ahora hemos visto cómo una empresa puede encontrar valor en información que no estaba utilizando. Falta una decisión igualmente importante: reconocer cuándo ese esfuerzo no compensa. No todos los datos oscuros esconden oportunidades.
Matriz de decisión para Dark Data
| APROVECHAR | Existe una finalidad legítima, calidad suficiente y una decisión que mejorar. |
| CORREGIR | La información es potencialmente útil, pero necesita limpieza, contexto o actualización. |
| RESTRINGIR | Hay información sensible, confidencial o limitaciones de acceso que requieren controles. |
| ELIMINAR | La conservación ya no está justificada y no existe obligación que exija mantenerla. |
La última decisión debe respetar las obligaciones legales, contractuales y de conservación aplicables.
Una empresa que guarda todo indefinidamente puede acabar aumentando costes, exposición al riesgo y dificultad para encontrar información fiable. En ocasiones, la mejor decisión sobre un conjunto de Dark Data es no recuperarlo.
Cómo empezar una auditoría de Dark Data en tu empresa
No necesitas comenzar con un proyecto tecnológico de gran presupuesto. Puedes realizar una primera exploración limitada a un proceso empresarial y tres fuentes de información.
Elige una pregunta concreta, identifica quién conoce los datos y comprueba si su utilización está justificada. Después completa una ficha para cada fuente:
| Campo | Qué debes registrar |
|---|---|
| Fuente | Sistema o repositorio donde se encuentran los datos |
| Responsable | Persona o equipo que conoce su origen |
| Finalidad | Decisión o proceso que podrían mejorar |
| Calidad | Completitud, actualidad, duplicados y limitaciones |
| Acceso | Permisos, restricciones y condiciones de uso |
| Valor potencial | Hipótesis que merece comprobarse |
| Coste | Preparación, mantenimiento y herramientas |
| Decisión | Aprovechar, corregir, restringir o eliminar |
El resultado inicial no tiene que ser un sistema de IA. Puede ser un inventario que permita priorizar una prueba pequeña y descartar otras iniciativas.
Si esa prueba demuestra valor, tendrás argumentos para ampliar el trabajo. Si no, habrás evitado invertir en una plataforma que únicamente habría acumulado más información.
De los datos ocultos al conocimiento empresarial
Volvamos una última vez a Nébula. La empresa empezó con un problema: sabía cuántos clientes perdía, pero no comprendía suficientemente sus motivos.
La información estaba repartida entre departamentos. Recuperarla exigió definir una pregunta, localizar fuentes, comprobar permisos, evaluar calidad y contrastar una hipótesis.
El aprendizaje importante no fue descubrir una herramienta nueva. Fue comprender que una parte del conocimiento necesario para mejorar el negocio ya existía, aunque nadie lo estuviera utilizando conjuntamente.
El valor de los Dark Data lo vas a encontrar cuando tu organización convierta información acumulada en conocimiento fiable y ese conocimiento en mejores decisiones. Y también cuando aprenda a distinguir qué información y conocimiento hay que acumular para reutilizar en el futuro.